
Разработка высоконагруженных систем
Проектируем и дорабатываем сервисы под рост пользователей, данных и операций. Проверяем архитектуру нагрузочными тестами и делаем поведение системы наблюдаемым.
Можно без ТЗ. Начнём с вашей идеи и задачи.
01 / ВОЗМОЖНОСТИ
Что можем разработать
Архитектура под нагрузку
Кеширование, очереди, разделение компонентов и масштабирование по измеримым потребностям.
Оптимизация сервиса
Находим узкие места в запросах, API, обработке событий и использовании ресурсов.
Наблюдаемость и эксплуатация
Метрики, логи, алерты, нагрузочные сценарии и процедуры восстановления.
02 / СОСТАВ РАБОТ
Что получит ваша команда
Сначала измеряем текущую нагрузку и определяем целевые показатели: время ответа, пиковые запросы, объём данных и допустимое время восстановления.
-
Профиль нагрузки
Сценарии, пики, набор данных и критерии производительности.
-
Архитектура и код
Изменения в приложении, базе и инфраструктуре под найденные ограничения.
-
Отчёт по проверкам
Результаты нагрузочных тестов, ограничения и рекомендации.
-
Эксплуатация
Мониторинг, инструкции по релизам и план дальнейшего масштабирования.
03 / НАШ ОПЫТ
Проекты команды
Посмотреть все кейсыПроекты из нашего портфолио. Состав работ, технологии и реализованные функции — в каждом кейсе.
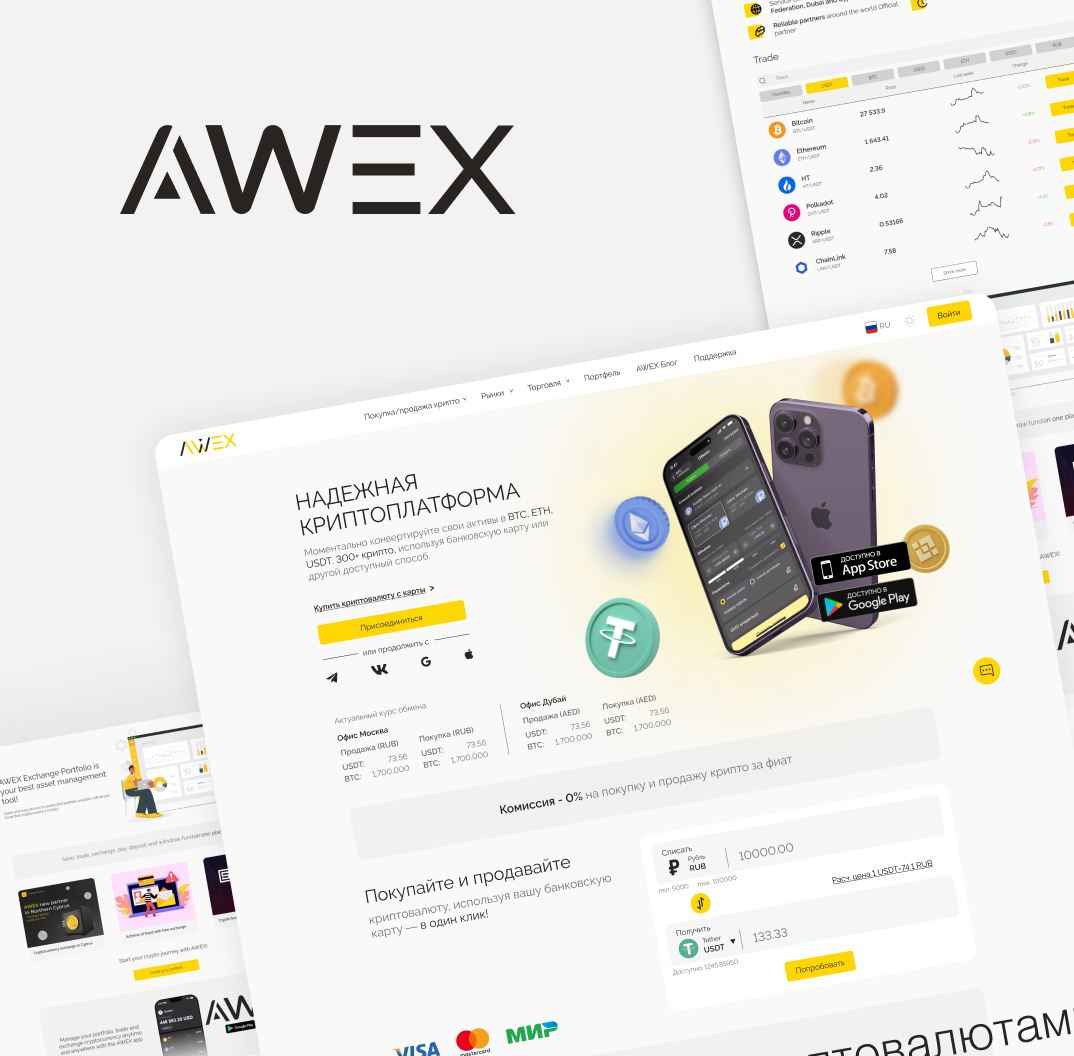
Awex
B2B сервис для криптобиржи
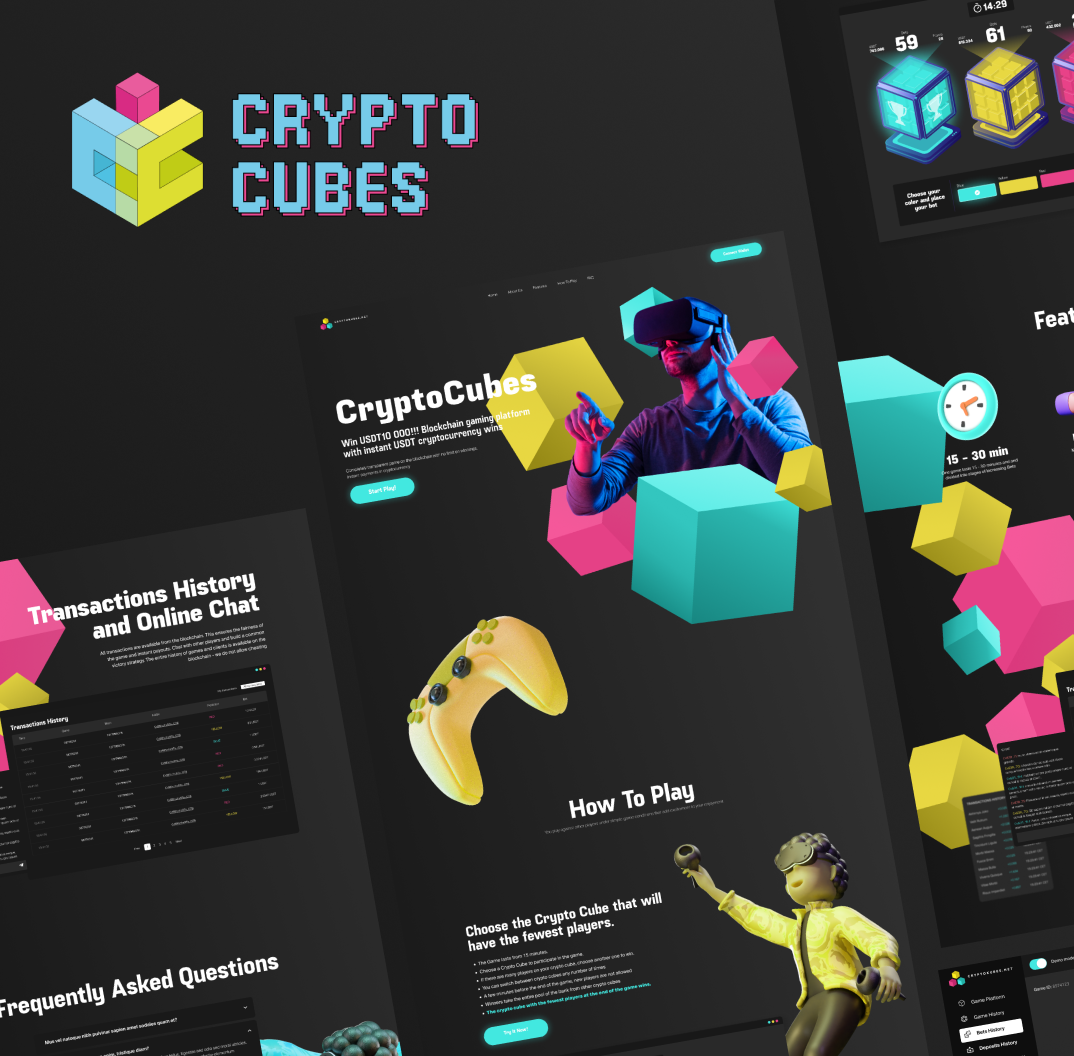
CryptoCubes
Блокчейн игра смарт-контракте Tron

Zoom Loupe
Telegram MiniApp игра
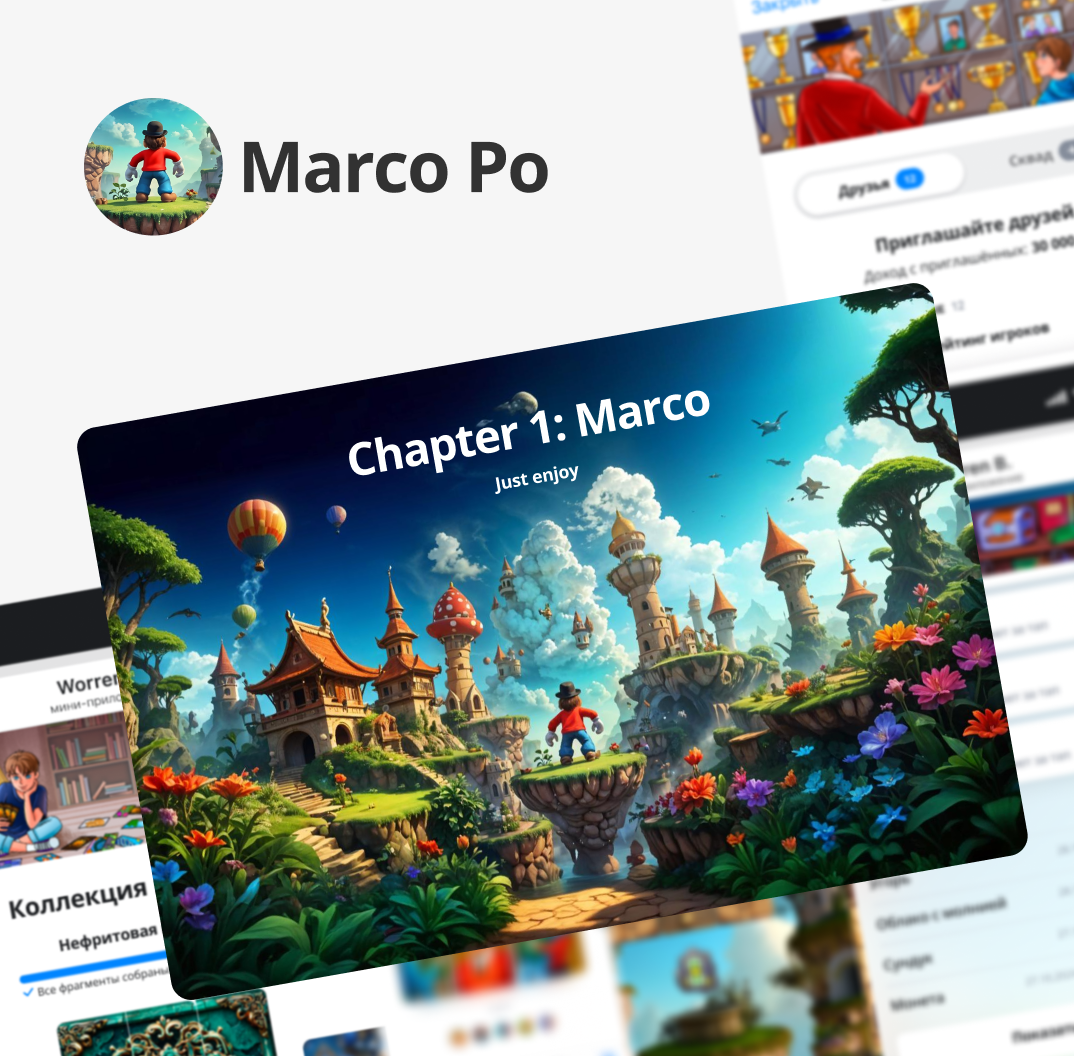
Marco Po
Telegram MiniApp тапалка с Puzzle механикой

Alo Finance
Личный кабинет инвестора

True Detects
Front-End для аналитического трейдинг сервиса
04 / ПРОЕКТИРОВАНИЕ
Что учитываем до разработки
Целевые показатели
Не обещаем абстрактные миллионы запросов: проверяем согласованный профиль нагрузки.
Отказоустойчивость
Обсуждаем деградацию сервиса, резервирование и восстановление данных.
Стоимость инфраструктуры
Сопоставляем запас мощности, операционные расходы и бизнес-приоритеты.
Технологии и интеграции
Технологии
05 / СТОИМОСТЬ И СРОКИ
Оценка под вашу задачу
Сначала фиксируем первую версию и критерии готовности. Затем оцениваем разработку, интеграции и проверки по этапам.
Первая версия
Целевые нагрузки, объём данных и ограничения текущей архитектуры.
Логика и интеграции
Количество компонентов, очередей, баз и внешних зависимостей.
Проверки и запуск
Нагрузочный профиль, отказные сценарии и мониторинг.
06 / ПРОЦЕСС
От обсуждения к рабочему продукту
-
Разбираем задачу
Изучаем продукт, пользователей и ограничения. Фиксируем приоритеты.
-
Проектируем
Согласуем сценарии, архитектуру и критерии приёмки.
-
Разрабатываем
Показываем промежуточный результат, проверяем функции и интеграции.
-
Запускаем
Готовим релиз, передаём исходники и согласуем дальнейшую поддержку.
Клиенты о работе с нами
Все отзывыВ итоге получили полноценный рабочий продукт. Команда ответственная, на связи и заинтересована в результате. Могу рекомендовать для разработки сложных проектов.
Разработка продукта
Фрагмент отзыва
Команда погрузилась в проект, предложила понятную архитектуру и поэтапный план работы. Все ключевые функции MVP были реализованы с учетом требований к безопасности и масштабированию.
Криптовалютный кошелёк · Web & Mobile
Фрагмент отзыва
07 / ПОЛЕЗНОЕ
Вопросы и ответы
Когда бизнесу нужна именно highload-разработка?
Когда сервис должен выдерживать тысячи одновременных пользователей, всплески трафика в пиковые часы или регулярные ресурсоёмкие операции: обработку платежей, стриминг, аналитику в реальном времени. Если обычная архитектура начинает падать под нагрузкой — это наш профиль.
Как вы проектируете архитектуру под высокие нагрузки?
Разделяем систему на независимые сервисы, выносим тяжёлые операции в очереди (Kafka, RabbitMQ), настраиваем кеширование на Redis, шардируем и реплицируем базы данных. Узкие места ищем расчётом нагрузки ещё до написания кода.
Проводите ли вы нагрузочное тестирование?
Да, это обязательный этап: моделируем реальные профили трафика в k6 и Locust, профилируем код и базу, находим предел системы и точки деградации. По итогам — отчёт с цифрами и планом оптимизации.
Можете ли оптимизировать уже работающую систему, которая не справляется?
Да. Начинаем с аудита: метрики, логи, медленные запросы, архитектура. Затем устраняем узкие места поэтапно — без остановки сервиса и переписывания всего с нуля.
Какую инфраструктуру и мониторинг вы используете?
Kubernetes с автомасштабированием, балансировщики нагрузки, Prometheus и Grafana для метрик, централизованные логи и алертинг. Команда узнаёт о проблеме раньше пользователей.
Сколько стоит и как долго строится высоконагруженная система?
Оцениваем состав первой версии, интеграции, готовность исходных данных и объём проверок. После обсуждения задачи даём оценку по этапам, отдельно обозначаем внешние сервисы и дальнейшее развитие.
Обсудить проект
Начнём с вашей задачи
Расскажите, что хотите создать или улучшить. Обсудим первую версию, зависимости и следующий шаг.